

アウトカムの定義、レビュー再設計、暗黙知の形式知化― AI駆動開発組織になるために必要だったもの
タスク分解から自律実装までをこなす「AIエージェント」の登場によって、ソフトウェア開発のあり方が根本から変わろうとしているなか、私たち博報堂テクノロジーズでは、ツールの導入にとどまらず、「全社的な開発プロセスの再設計」へと舵を切りました。
先行導入された約40名の組織では、週次のリリース速度が平均81%向上し、週次最低リリース数も約4倍へと増加しました。単なる作業効率化を超え、エンジニアの「評価」や「レビュー」まで再設計した、AI前提組織への刷新の全貌について、開発プロセスの設計を主導したケヴィン・クラッツァさんと、現場で実践・推進を担う鏡川悠介さんに話を伺いました。
ケヴィン・クラッツァ
株式会社博報堂テクノロジーズ開発第3センター Ad Ops開発1部・2部部長 全社AI駆動開発推進プロジェクトメンバー
AdTechや複雑なシステム開発に精通した博報堂テクノロジーズのエグゼクティブマネージャー。AIスタートアップにてマネージャー兼プリンシパルエンジニアを経て2023年に現職。5つのフルスタック開発チームを率い、センターのAI駆動開発導入をリードし、全社AI駆動開発推進プロジェクトに参画中。ミュンヘン工科大学情報科学修士(優等)、米大学でエグゼクティブMBA取得(優等)。技術と経営の両面からリード。
鏡川 悠介
株式会社博報堂テクノロジーズ開発第3センター CREATIVE BLOOM開発部 チームリーダー
2022年、株式会社博報堂テクノロジーズに入社。以来、広告クリエイティブプラットフォーム「CREATIVE BLOOM DISPLAY Ads」の開発に従事し、現在はチームリーダーとして開発全体を牽引するかたわら、AI駆動開発のチームへの導入・定着を主導。生成AIを活用した開発プロセスの変革に日々取り組んでいる。
目次
01 AI駆動開発組織への転換、その背景
02 AI時代の「アウトカム」をどう定義したか
03 レビューをどう再設計したのか
04 暗黙知をどう形式知に変えたのか
05 AI導入によって組織に起きた変化
06 AI駆動開発組織のこれから
局所的な効率化ではなく、AIを前提とした「全体プロセスの刷新」へ
生成AIが「補助」から「自律(エージェント)」へと役割を変える中で、開発現場にはどのような変化が起きているのでしょうか。
ケヴィン:これまでのAIツールは、主にエンジニアが主体となり、コードの補完など「1行単位の補助(オートコンプリート)」として機能していました。しかし、昨今の「エージェント型AI」の登場によって、状況は劇的に変わりました。エージェントは自らタスクを分解し、実行し、エラーを修正しながら実装を進めるようになりました。
つまり、エンジニア自身が設計、実装などのプロセスすべてを担う開発から、「人間が設計や判断を担う」「実装はAIエージェントが担う」という分担された開発へと変わり始めています。
AIツールの配布にとどまらず、「プロセスの書き換え」にまで踏み込んだ理由を教えてください。
ケヴィン:エンジニアにツールを渡すだけでは、組織としての大きなインパクトは生まれません。ソフトウェア開発には、要求から要件定義、実装、品質チェック、レビュー、リリースまで、すべての「全体プロセス」が存在するからです。
その中の一部である「コーディングだけ」をAIによって高速化しても、全体のプロセスがAIを前提に最適化されていなければ、最終的なリリース速度は上がらず、価値を届けるリードタイムも縮まりません。
そこで私たちは、「まずAIで解決することを前提としてプロセスを組み立てる」という、「AIファースト開発」に踏み込みました。
この大規模な組織変革は、どのように現場へ定着させていったのでしょうか。
ケヴィン:まずはアジャイル開発・内製開発を主体とする「開発第3センター」の約40名で先行してプロジェクトをスタートさせました。
当初は「3ヶ月で3チームに展開し、その後に他チームへ広げる」という計画でしたが、実際に始めると現場から「自分たちのチームでも早く使いたい」という声が次々と上がり、結果として、予定を大幅に前倒しし、開始からわずか1ヶ月半で8チームすべてのエンジニアへ一気に展開することになりました。現場での定着を支えた最大の要因は、各チームに配置した「AIエヴァンジェリスト」の存在です。
鏡川:チームによって、扱っているシステムも、技術スタックも、品質基準も全く異なります。金銭的なトラブルが絶対に許されない厳格なシステムもあれば、早々にリリースしてユーザーのフィードバックを得たいプロトタイプ的なシステムもあります。そのため、組織一律の共通ルールを押し付けるのではなく、各チームのコンテキストに合わせてAIの導入プロセスをローカライズする必要がありました。
それを担ったのが、現場をよく理解しているエヴァンジェリストたちです。エヴァンジェリストは単なる有志のボランティアではなく、正式な業務目標として評価制度に組み込まれているため、「既存の開発業務に追われてAIの推進ができない」というジレンマに陥ることなく、安心して推進に時間を投資することができました。
アウトカムを定義し、可視化しエンジニアの評価指標に
AI駆動開発の効果を測定するにあたり、どのような評価指標を設定したのでしょうか。
ケヴィン:開発生産性の測定は、AIが登場する前から非常に難しい問題でした。よくある「記述されたコードの行数」や「ストーリーポイントの消化数」などを指標にしてしまうと、組織に悪いハックが生まれるリスクがあります。
行数を競えば綺麗ではない冗長なコードが増え、ストーリーポイントを追えば見積もりをインフレさせていくといった、数字を達成するための不健全な行動が起こり得ます。
AI駆動開発の初期においても、「AIが生成したコードの割合」や「トークン消費量」を追うアプローチも検討されましたが、これらも本質的ではありません。AIを無駄に多く回してコストを跳ね上げ、重要ではないタスクを大量に繰り返しているだけの状態でも、あたかも生産性が高いように見えてしまうからです。
では、なにをもって「効果」と定義したのでしょうか。
ケヴィン:私たちは、ソフトウェアが改善され、最終的に「リリースできたこと(価値がユーザーに届いたこと)」が重要だと定義しました。プルリクエストが上がった量ではなく、「本当にユーザーに価値がデプロイされたか」こそが見るべき指標です。
そこで私たちは、評価指標を「リリース間隔やサイクルタイム」へとシフトさせました。毎週・毎月、どれだけ早いサイクルで顧客に価値を届けられているかを観測するのです。
この指標のアンラーニングを行い、70週間のモニタリング(導入前36週間、導入後34週間)を実施した結果、以下のようなアウトカムが確認されました。
- 平均週次リリース数:21件→38件(+81%)
- 週次リリース数の最低値:4件→17件
不調な週であってもリリース4倍程度を記録しており、開発のスループットが劇的に向上し、かつ、安定したことが可視化されたのです。
その「リリース頻度」や「サイクルタイム」は、どのように観測しているのでしょうか。
ケヴィン:私たち自身がAIを使った高度な開発ができる組織になっていたため、「ツールは自作すればいい」と考え、GitHubのプルリクエスト情報やコミット数、各種変更の動向を抽出・分析する独自のモニタリングツールを内製しました。これにより、感覚的な「早くなった気がする」ではなく、客観的なファクトとしてアウトカムを可観測化できています。
AI時代のレビュー再設計と、暗黙知から形式知へ転換するAI活用
AIの生成スピードが上がると、それだけ大量のコードが作られ、人間側のレビューが追いつかずボトルネック化しませんか?
ケヴィン:AIによる大量のコードを、人間がすべて目視で細かくレビューしていたら、時間がいくらあっても足りません。レビューが詰まってしまえば、リリースの流れは止まってしまいますから、「それならばAIを使わず従来通り人間が書けばいい」という転倒した結論になってしまいます。
そこで私たちは、人間が目を通す前の段階で、機械的に問題のあるコードを排除し、人間のレビュー負荷を下げる以下のような「3層の自動品質ゲート」を構築しました。
- 第1層:AI自動レビュー(プルリクエスト作成時にAIがコードを自動チェックし、改善点を指摘)
- 第2層:静的解析(「SonarQube」を開発第3センター全体に導入。循環的複雑度やセキュリティの脆弱性、お作法を機械的に弾く)
- 第3層:自動テスト(「Playwright」などを用いたUIテストやインテグレーションテストを導入し、リグレッションを機械的に検出)
これらはいわば「守りのアーキテクチャ」です。こうした仕組みがあるからこそ、他の場所を壊していないかというリスクを低減させ、人間は安心してレビューに臨めます。自動確認をすべてクリアした「安全性の高いコード」だけが人間の元に届くため、人間のレビュー負担は非常に軽くなっています。
現場では、AIにプロジェクトの「コンテキスト(文脈やルール)」をどのように学習させているのでしょうか。
鏡川:私たちは、AIをチームの作法に合わせて動かすために、現在20個ほどの自作スキル・ツールを用意しています。
たとえば、業務固有の知識やチームの暗黙知をAIにチェックさせる「ドメイン知識レビュー」や、要件定義の漏れやすい観点を自動チェックする「要件定義深掘り」、さらに決まったフォーマットで「プルリクエストを自動作成するスキル」などです。
これらは単にエンジニアが手動でAIを呼び出して使うだけでは、使い忘れが発生してしまいます。そのため、GitHub上の「プルリクエストが作成された」あるいは「実装計画が完了した」といった特定のイベント(フック)を検知し、自作のフック機能から確実にこれらのスキルを自動で実行する仕組みを作りました。これにより、誰が開発を担当しても、同じような高品質なAIのサポートとチェックが自動的にプルリクエスト上で実行されるようになっています。
開発にはチームや個人の内部にある「暗黙知」が必要な場面もあると思います。暗黙知をどのようにAIが活用できる「形式知」にしているのでしょうか。
鏡川:既存のドキュメントをAIに読み込ませるだけでは、日々変化する開発のコンテキストには追いつきません。私たちのチームでは、開発プロセスを回す中で自然と「暗黙知」が「形式知」へと転換され、AIのナレッジとして蓄積されていくループを構築しています。
具体的な仕組みを資料とともにお話します。Claudeのスキルが参照するナレッジとして、過去のインシデントパターンや類似機能の仕様、アーキテクチャ、そしてこれまでチーム内で言語化されていなかった「暗黙のチーム規約(明文化されていない情報)」を蓄えています。
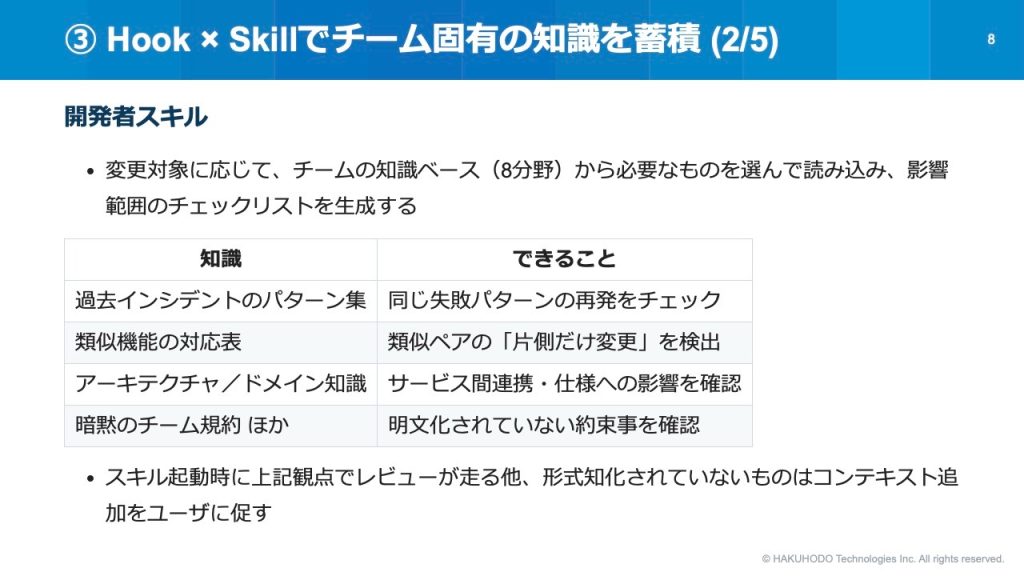
そして、要件定義から実装に入る「実装計画の策定時」と、実際にコードを実装した後の「プルリクエストレビュー時」の2段階で、自作のレビュースキルをフックによって確実に自動実行させます。
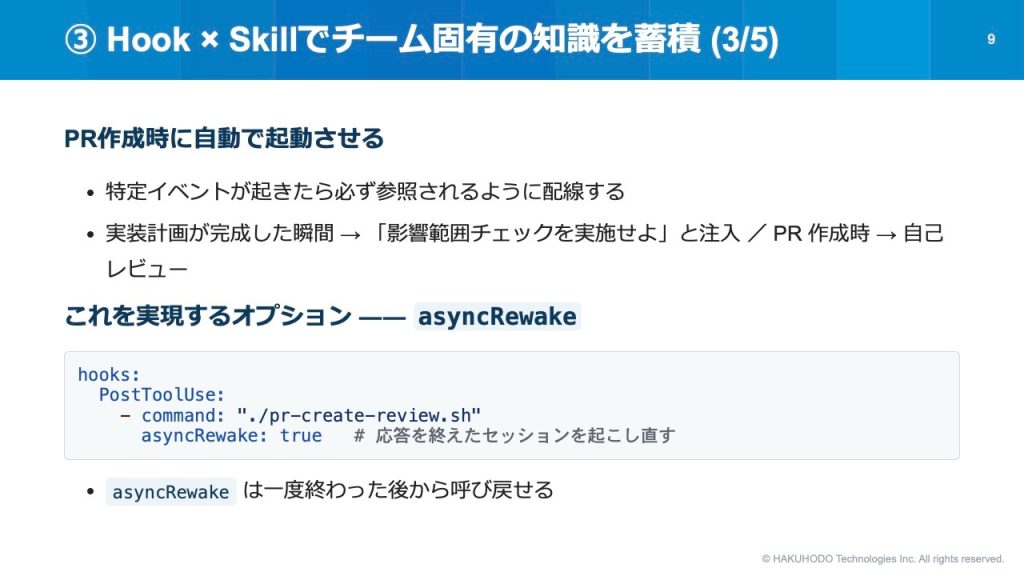
特に実装後のプルリクエストレビューの段階では、AIがプルリクエスト内のコードやテスト結果、さらにエンジニアとAIが開発中に交わしたチャットセッションから、「まだナレッジベースに登録されていない新たな仕様ルールや、今回の開発で得られた新たな暗黙知」をAI自身に自動抽出(収集)させます。抽出されたナレッジは自動的に形式知(Markdownなどの構造化データ)に変換され、プールされます。
これにより、次回別のエンジニアが似たような領域を開発する際には、新しく蓄積された形式知が自動でフックされ、チェックルールとして自動適用される仕組みになっています。
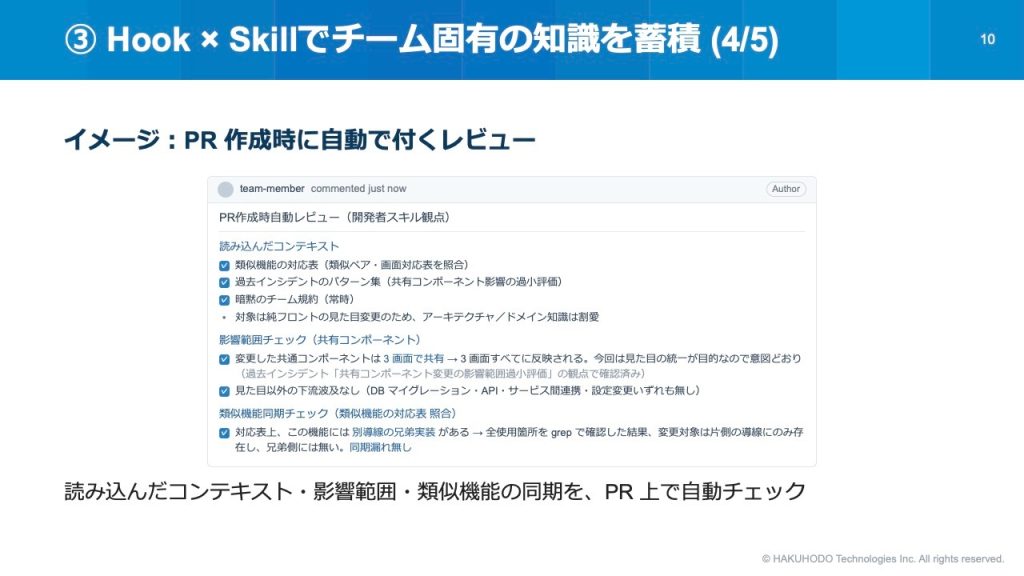
人間が「wikiにマニュアルを書く」という作業をすることなく、エンジニアが日常的にAIと開発セッションを行うこと自体が、組織のナレッジを強化するドキュメンテーション活動に直結しているのです。
検証環境の自動デプロイ、指摘コストを低減する「UIレビューChrome拡張」
実際に人間が動作確認をする際にも、なにか工夫があるのでしょうか。
鏡川:コードを画面上で読むだけでなく、実際に動かしてみる「UIレビュー」を実行しやすくするための環境ハックを行っています。
プルリクエストを作成すると、そのコード差分からAWS ECS上へ一時的な検証環境(プレビュー環境)が自動的にデプロイされ、プレビュー用のURLがプルリクエストのコメントに自動通知されます。レビュアーは、そのURLをブラウザで開くだけで、最新の挙動を即座に動かして確認できます。
さらに、そのブラウザ上で見つけた不具合やデザインの崩れを起票するコストを下げるために、自作の「UIレビュー用Chrome拡張」を開発しました。
- 1. ブラウザ上の気になる画面要素を1クリックで選択する
- 2. その場で「文字を大きく」などのコメントを記入する
- 3. すると、自動的にその要素のセレクタやビューポート情報を含んだMarkdownが生成され、コピーできる
こうした一連の流れを経て、プルリクエストのコメント欄にそのまま貼り付けるだけで、簡単にUIフィードバックの起票が完了します。これにより、指摘の作成にかかる手間を大幅に削減できました。
「なにを見て、なにを見ないか」リスクベースのレビューの濃淡設計
AIによる自動化が充実していくなかで、人間はなにをレビューしているのでしょうか。
ケヴィン:AIが作ったものすべてを必ずしもレビューする必要はないと考えており、「リスクの高さ」に応じて、レビューの濃淡をつけるようにシフトしています。
たとえば、博報堂テクノロジーズとして絶対にチェックを緩めてはならない領域は明確に指定しています。インフラの変更(誤ってS3バケットをパブリック設定にしてデータが漏洩するなどのリスク)や、セキュリティ、認証、ロギング、そして大きなビジネスロジックや金銭的トラブルに関わる領域です。これらはAIだけでなく人間が徹底的に確認します。
一方で、あるチームでは実験的に「フロントエンドでロジックを持たず、デザイン崩れといった要素がリスクとなるような部分」については、前述の「3層の自動品質ゲート」をすべて通過させたうえで、人間によるダブルチェックをスキップし、作成者が責任を持てばそのままマージして良いというルールを導入しています。
仮にデザインが多少崩れたとしても、データ漏洩などの致命的なリスクは考えにくく、テストで問題がなければ重大な問題になりにくいと考えられます。このように「なにをやらないか」を定義することで、人間が最も本質的なレビューに集中できる余白を生み出しています。
AI時代に直面する「新たな痛み」へのアプローチと、必要とされるエンジニア像
一方で、AI前提になったことで見えてきた「次なる課題」や「現場の痛み」はありますか?
鏡川:まさにそこが今、私たちが最もリアルに向き合っている難所です。大きな課題として、以下の3つが挙げられます。
- 1. 理解・認知負債:AIが瞬時にコードを生成するため、自分でいちから書いていない分、コードやシステム全体への理解が低下する
- 2. 保守工数の増大:開発速度が上がり、生成されるコードの量が増えた分、メンテナンスし続けなければならないコードが増える
- 3. 若手育成の機会損失:AIが先にコードの正解を出してしまうため、若手エンジニアが泥臭く試行錯誤を繰り返すことで得られる地力の育成機会が奪われる
これらの「痛み」に対して、私のチームでは新しいアプローチを試験的に取り入れています。
たとえば、「コードを読まなければ理解できない」という認知負債を解消するために、私のチームでは、「3層の自動品質ゲート」をすべて通過することを前提に、プルリクエスト作成段階での「コードの目視レビュー」を必須とはしていません。その代わり、マージした後に、「検証・ステージング環境」で徹底的にバグを潰し切るアプローチを採り入れています。具体的には、毎週チーム全員でデプロイされた最新の機能を実際に触り倒す「モンキーテスト会」を開催しています。
全員で画面を動かしながら「ここはバグりそうだ」「ここのボタンは表示が変だ」とディスカッションしながら触ることで、コードを読んでいなかった分のシステム理解を効果的に補完し、認知負債を乗り越える工夫をしています。
ケヴィン:積極的に若手育成の機会を創出する動きも採り入れています。たとえば、新卒などジュニアのエンジニアは、AIで生成したコードが「なぜこれが正しいと思うか」をシニアクラスのエンジニアに説明する機会をつくっています。
AIがコードをすべて書くようになった時、これからのエンジニアに求められる素養や、理想的なエンジニア像とはどのようなものでしょうか。
ケヴィン:「コードを書く」というスキルの希少価値は薄れていかざるを得ません。そのぶん、エンジニアの価値の源泉は、「なにが正しいか」を「正しく判断する能力(判断力)」、そして「どうすればユーザーが喜び、ビジネスにインパクトを出せるか」を考え抜くプロダクト志向に移っていくでしょう。
博報堂テクノロジーズには「Challenge & Support(挑戦を続け、支え合う)」や「Be Proactive(主体的であれ)」という行動指針(バリュー)がありますが、AI駆動開発の現場において、このバリューは有用な武器になります。AIが不確実な挙動をしても、それを恐れずにチャレンジし、新しいプロセスを自ら進んでデザインし、チームのために主体的に動ける人こそが、これからのAI前提時代の主役になっていくと考えています。
鏡川:実装という手段に固執せず、ユーザーの業務知識(ドメイン知識)や、目の前にある顧客のリアルな課題にどこまで泥臭く寄り添えるか。それができるエンジニアこそが、AIに代替されない「真の価値」を発揮できるのだと思います。
ケヴィン:私たちのAI駆動開発は、まだ始まったばかりです。開発プロセスだけでなく、組織全体がAIネイティブに変革していくロードマップの次の段階へと、さらに大きく変化し続けていきます。チャレンジしていく余地はまだたっぷりと残っています。
※ 記載内容は2026年9月時点のものです
Share:


